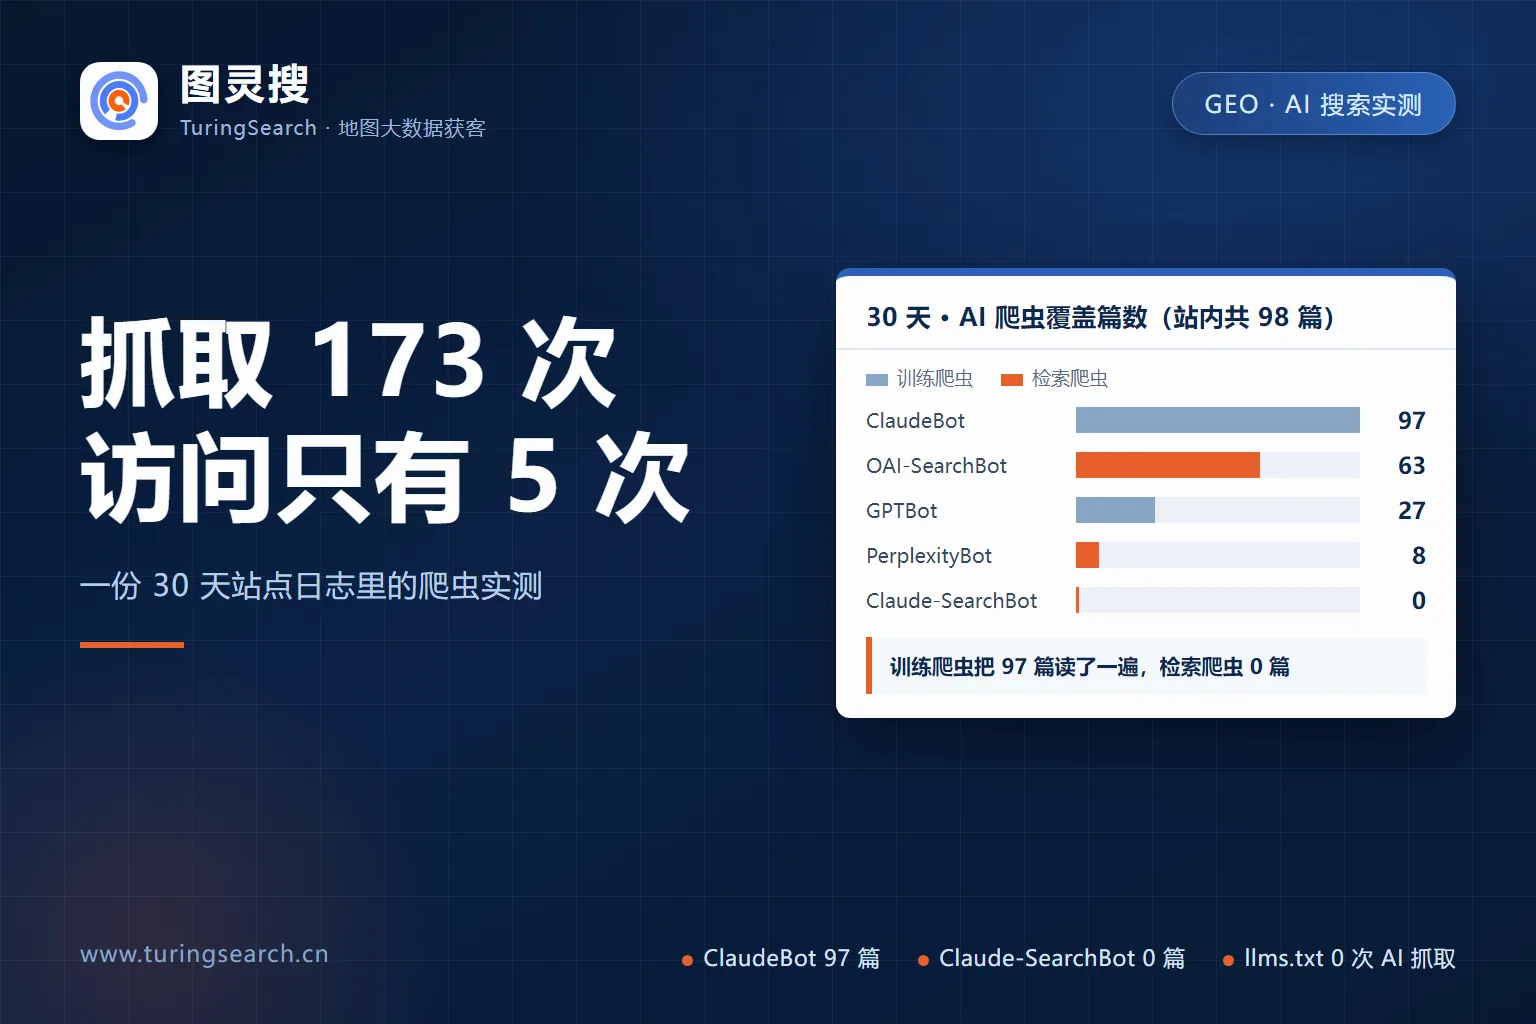
GEO 被讲得越来越玄。我们把这台服务器 30 天的访问日志导出来,按爬虫名字一条条数了一遍:AI 爬虫来了,训练爬虫甚至把 98 篇文章读了个遍,但 30 天里由 AI 助手带来的真实访问只有 5 次。抓取、索引、引用、访问,是四件不同的事,这篇用一份真实日志把它们拆开。
我们做了一件有点笨的事:把这台服务器 30 天的访问日志全部导出来,按爬虫的名字一条条分类数了一遍。要回答的问题只有一个——AI 到底有没有在用这个站上写的东西。结果很分裂:爬虫来了,而且来得很勤;但 30 天里由 AI 助手带来的真实访问,只有 5 次。
这篇文章不讲"GEO 应该怎么做"的步骤。它讲的是把一份真实日志摊开之后,看到的几组对不上的数字,以及哪些关于 GEO 的说法经不起这份日志的检验。
先看数据:30 天里 AI 爬虫在这个站点做了什么
口径先交代清楚。统计窗口是 2026 年 9 月 10 日到 10 月 10 日,日志共 272,182 行。"覆盖篇数"指这段时间里至少被抓过一次的站内文章数,分母是 sitemap 里的 98 篇;"请求"一列只算返回 200 的那部分。列表页、标签页和改版留下的历史旧路径都已剔除——不做这一步,数字会虚高,这一点后面会再提。
| 爬虫 | 归属 | 干什么用 | 文章页请求 | 覆盖篇数(共 98) |
|---|---|---|---|---|
| bingbot | 微软 | Bing 搜索,也是 Copilot 的索引来源 | 2,995 | 97 |
| ClaudeBot | Anthropic | 训练模型 | 97 | 97 |
| Applebot | 苹果 | Spotlight、Siri 与 Safari 建议 | 88 | 86 |
| YandexBot | Yandex | 搜索 | 88 | 67 |
| OAI-SearchBot | OpenAI | ChatGPT 搜索的索引,决定你会不会被引用 | 173 | 63 |
| Googlebot | 谷歌 | 谷歌搜索,同时为 AI Overviews 提供内容 | 183 | 63 |
| GPTBot | OpenAI | 训练模型 | 31 | 27 |
| Bytespider | 字节跳动 | 训练模型 | 328 | 26 |
| ChatGPT-User | OpenAI | 用户在对话里让它读某个页面时才触发 | 45 | 23 |
| PerplexityBot | Perplexity | 搜索索引 | 10 | 8 |
| Claude-SearchBot | Anthropic | Claude 搜索的索引 | 0 | 0 |
| Claude-User / Perplexity-User | — | 用户触发抓取 | 0 | 0 |
把这张表从上往下读,会看到一件事:同一家厂商的两只爬虫,覆盖范围可以差到"全读"和"一页没读"。
最典型的是 Anthropic。ClaudeBot 把 98 篇里的 97 篇读了一遍,它是用来训练模型的;而同属 Anthropic、专门为 Claude 的搜索索引工作的 Claude-SearchBot,30 天里一篇都没抓。训练那只把内容取走了,检索那只看都没看。
OpenAI 那边是另一种形态:训练用的 GPTBot 只抓了 27 篇,而负责"会不会被 ChatGPT 引用"的 OAI-SearchBot 抓了 63 篇,覆盖面明显更宽。同一家公司的两只爬虫,行为模式并不一样,只看汇总的"AI 抓取量"会把它们彻底混掉。覆盖最窄的是 Perplexity 的检索爬虫,只碰到 8 篇。
抓取、索引、引用、访问,是四件不同的事
上面那组数字之所以容易被读错,是因为很多人把"抓取量"当成了最终成绩。这中间其实隔着四层,每一层都能卡人:
| 这一层 | 发生了什么 | 能不能直接看到 | 我们这个站的情况 |
|---|---|---|---|
| 抓取 | 爬虫把页面取回自己的服务器 | 能,访问日志里就有 | 97 / 98 篇(ClaudeBot) |
| 索引 | 内容被存进可检索的库 | 看不到,只能从"搜得到"反推 | 无公开口径 |
| 引用 | AI 在回答里把某一句写进去当来源 | 基本看不到 | 无公开口径 |
| 访问 | 用户顺着引用点过来,或记住名字去搜 | 能,从 referer 里看 | 30 天 5 次 |
四层之间不会同步。抓取那一层跳动,下面三层可能一动不动——这就是"后台显示 AI 抓取量涨了,询盘却没变"的常见原因。真正决定生意的是第三层和第四层,而这两层在服务器日志里几乎看不见,只能靠两个替代信号去估:来自 AI 域名的 referer,以及品牌词的直接搜索量。
我们这份日志能看到的最后一层,是这个数:30 天里来自 chatgpt.com 的访问一共 5 次,落在 3 个页面上,其中 2 次是首页。同一个窗口里,OAI-SearchBot 抓文章页抓了 173 次。抓取 173 次,带回 5 次访问,这就是"被抓"和"被用"之间的距离。顺带说明一点:AI 助手的引用链接经常不带 referer,所以 5 次是下限而不是全集,但这个量级足以说明问题。
训练爬虫和检索爬虫:被混为一谈的那一对
AI 爬虫不是一类东西。按用途分,至少有三类,它们对"你会不会被推荐"的作用完全不同:
| 类别 | 代表 UA | 它的产出是什么 | 屏蔽它会发生什么 |
|---|---|---|---|
| 训练爬虫 | GPTBot、ClaudeBot、Bytespider、Google-Extended(开关型) | 喂给模型当作训练语料 | 退出训练,但不影响你在搜索答案里出现 |
| 检索爬虫 | OAI-SearchBot、Claude-SearchBot、PerplexityBot、Googlebot、bingbot | 建立搜索索引,是"被引用"的入口 | 退出对应的 AI 搜索答案,直接影响曝光 |
| 用户触发抓取 | ChatGPT-User、Claude-User、Perplexity-User | 有人在对话里点名让它打开某个链接 | 用户主动让你被读的时候读不到 |
这张表里最实用的一条推论:在 robots.txt 里屏蔽 GPTBot,不会让你从 ChatGPT 的答案里消失。GPTBot 只负责训练;要退出 ChatGPT 的搜索答案,屏蔽的必须是 OAI-SearchBot。很多站的 robots.txt 一看到"AI 爬虫"就整体拦掉,结果把训练和引用一起关了,等到发现 ChatGPT 不再提自己,已经过去几个月。
反过来也成立:把 AI 爬虫全部放行,并不等于就能被引用。我们的 robots.txt 早就显式放行了 GPTBot、OAI-SearchBot、ChatGPT-User、PerplexityBot、ClaudeBot、Bytespider,Claude-SearchBot 也落在默认放行的规则里。权限全开,Anthropic 的检索爬虫 30 天里仍然一页没抓。到这一步,问题已经不在 robots 上,而在引擎自己的索引覆盖还没轮到你——这件事你单方面改变不了,只能靠时间和站外信号去等。
llms.txt 实测:上线 30 天,27 次抓取、0 次来自 AI
我们按通行做法上线了 /llms.txt 和 /llms-full.txt:把站内文章整理成一份给机器看的清单,带摘要、按时间倒序、链接指向正式文章地址。
30 天里这两个文件一共被请求 27 次。按 UA 归类,这 27 次里没有一次来自 AI 爬虫——来自 SEO 检测工具,以及一批伪装成手机和电脑浏览器的代理 IP。
这个结果和外部证据对得上,下面三条都可以自己去核:
- Google 在生成式搜索的官方指引里,把 llms.txt 列进了"你不需要做的事",明确写了自家搜索不使用这类文件(该页 2026 年 7 月更新)。
- Ahrefs 统计了 137,210 个域名,2026 年 5 月有 97% 的 llms.txt 一个请求都没收到。
- SE Ranking 在引用预测的测试里把 llms.txt 从模型变量中拿掉,预测结果反而更准。
落地建议很简单:这个文件成本接近零,放着不碍事,将来真有引擎读它也不吃亏;但把它当成 GEO 的主要抓手,等于把力气花在一个目前没人读的文件上。本站 9 月那篇 GEO 实操把它放在第三步,这份日志算是给了它一个直接的检验结果。
那力气该花在哪:三条比配置 llms.txt 更值得做的
- 写出能被整句拿走的段落。AI 引用的是段落,不是页面。一段话里如果同时有数字、口径和可核对的来源,它就能被原样搬走;如果一段话要靠上下文才成立,它搬不走。所以每个小节开头那一两句,值得单独打磨。
- 让站外先提到你。AI 引用的信源里有相当一部分来自媒体、平台、榜单和评测,未必是当事人的官网。能被引用的事实——具体数字、可复核的结论、明确的行业口径——优先往外放,比自己站上多写十篇更管用。
- 把"你是谁"在全网统一成一个版本。公司名、域名、产品名、账号名各写各的,引擎就没法确认这些是不是同一个主体。官网、工商信息、社媒主页上的名称与链接保持一致,是让引擎把你认出来的前提。
三条里没有一条是配置类动作。GEO 走到今天,卡住大多数站点的很少是某个技术开关,多半是内容本身:有没有一句别人搜不到、又能被直接引用的话。
自己查一遍:三个可复现的动作
- 按 UA 数爬虫。在服务器的访问日志里,把请求按 User-Agent 分类,分别统计 OAI-SearchBot、ClaudeBot、Claude-SearchBot、PerplexityBot、GPTBot 各自的请求数,先看清谁来了。
- 和 sitemap 求交集。把每个爬虫抓到的路径,与 sitemap 里的真实文章 URL 做交集。这一步会剔掉大量失效的历史地址:我们第一遍统计时,Bing 抓到的唯一路径有 133 个,和站内 98 篇求完交集之后是 97 篇,多出来的都是改版留下的旧链接。
- 查 referer 里有没有 AI 域名。在日志里筛 chatgpt.com、perplexity.ai、claude.ai、gemini.google.com、copilot.microsoft.com 这些来源。这是目前唯一能直接看到"AI 到底带来了几单访问"的口径。
还有一个提醒:User-Agent 是可以伪造的。我们自己的日志里就有大量冒充 AI 爬虫的凭据扫描器,它们专挑 .env、云凭据这类路径去扫。所以按 UA 数出来的数字要再过一层——只看对内容页的请求(扫描器不抓文章页),必要时用厂商公布的 IP 段做二次校验。本文列出的数字都做了前两层过滤。
相关阅读
- GEO 的操作步骤(本站 9 月那篇,这篇是它的实测补充):GEO 怎么做?让 ChatGPT、豆包把你的产品写进答案
- 怎么确认自己的页面有没有被谷歌收进去:如何查询网页是否被谷歌收录?
- 把 AI 用进日常业务,而不是用在写稿上:外贸业务员怎么用 AI 提效?8 个实战场景
- 用一手数据做内容的例子:2026 年 1—8 月出口数据怎么读
- 获客工具怎么挑、怎么用:外贸获客软件怎么选
能被 AI 引用的内容,前提是它说了别人没有的东西。
这份日志给出的方向和产品无关,和内容习惯有关:数字要具体、口径要写清、来源要能核。图灵搜用地图大数据与海关进口记录核验买家的所在地、主营业务与采购规模,输出的正是这类可以直接引用的事实——哪个市场在增长、哪类买家在采购、单个买家的采购量级。免费试用:
工具定位与数据源说明可读:图灵搜是什么?
本文的爬虫与访问数据取自本站 nginx 访问日志,窗口 2026-09-10 至 2026-10-10(272,182 行),只统计 sitemap 中 98 篇文章页的请求;外部证据来自 Google Search Central 生成式搜索指引(2026-07 更新)、Ahrefs 对 137,210 个域名的 llms.txt 请求统计(2026-05)、SE Ranking 引用预测测试。站内自查可直接复用文中的三个动作,核对时间 2026 年 10 月 10 日。
相关阅读
免费下载图灵搜,体验地图搜客户
地图大数据搜索外贸买家,找客户、查数据、挖决策人,一次搞定。
